Un assistant IA dans Business Central sur votre propre modèle : une extension AL, morceau par morceau
Par Fred Morin ·
Aussi en anglais : A Business Central AI assistant on your own model: an AL extension, piece by piece
« Qui nous doit le plus en ce moment? » « Quels clients ont arrêté d'acheter? » « Qu'est-ce qui est en retard sur cette commande? »
Business Central a la réponse aux trois. Pour l'avoir, il faut savoir quel rapport rouler, quels filtres mettre, et parfois exporter dans Excel pour finir le travail.
Je voulais poser la question en mots simples, à partir de la page où j'étais déjà. Et je voulais choisir où roule le modèle : sur un PC au bureau, ou sur un service hébergé, sans rien réécrire. Alors je l'ai construit en extension AL. Cet article explique comment elle est montée.
44 secondes (en anglais) : une question, une question de suivi, et l'assistant qui ouvre une fiche client. Enregistré avec un modèle hébergé ; la même extension parle à un modèle local.
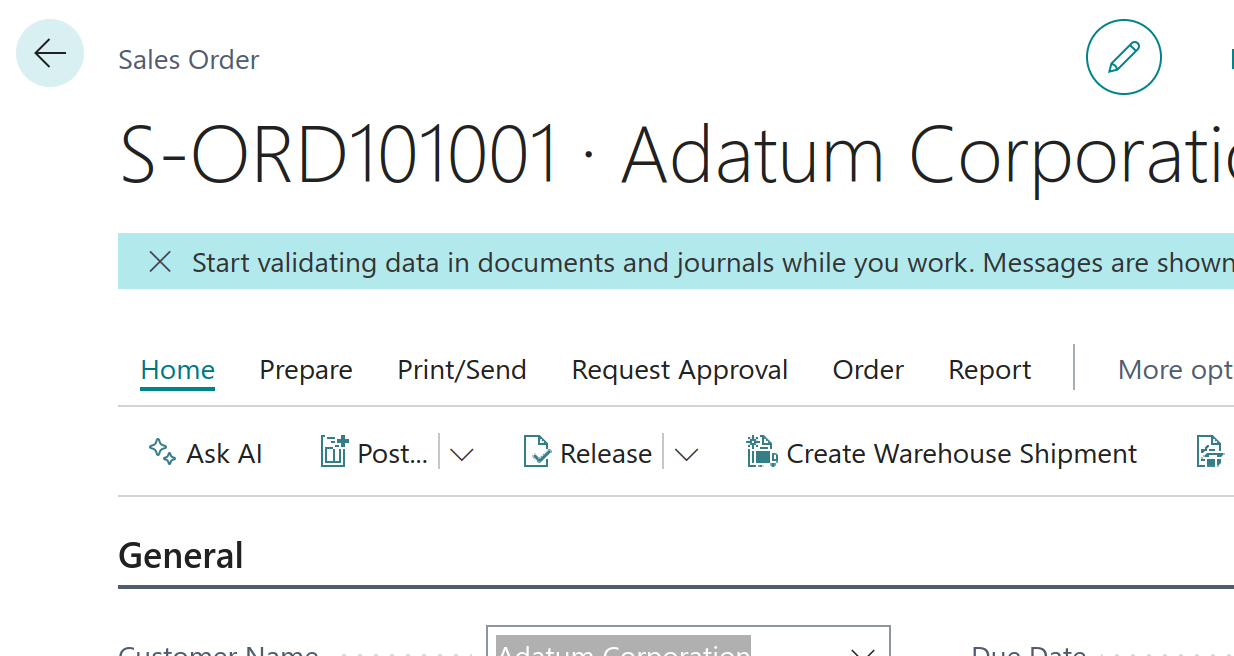
L'assistant s'ouvre à partir d'une action « Ask AI » sur la page que vous regardez.
Ce que fait l'assistant
- Il s'ouvre d'un bouton Ask AI sur les clients, fournisseurs, articles, contacts, documents de vente et d'achat, le plan comptable et le centre de rôle.
- Il sait de quel enregistrement on l'a ouvert.
- Il va chercher les données lui-même, dans la table dont la question a besoin.
- Il répond aux questions de type rapport : comptes clients et fournisseurs par âge, ventes par client, article ou vendeur, clients inactifs, état des stocks, commandes de vente ouvertes.
- Il peut ouvrir une fiche ou une liste pour vous.
Il ne peut rien créer, modifier, reporter ni supprimer. C'est un choix de conception, pas une fonction manquante.
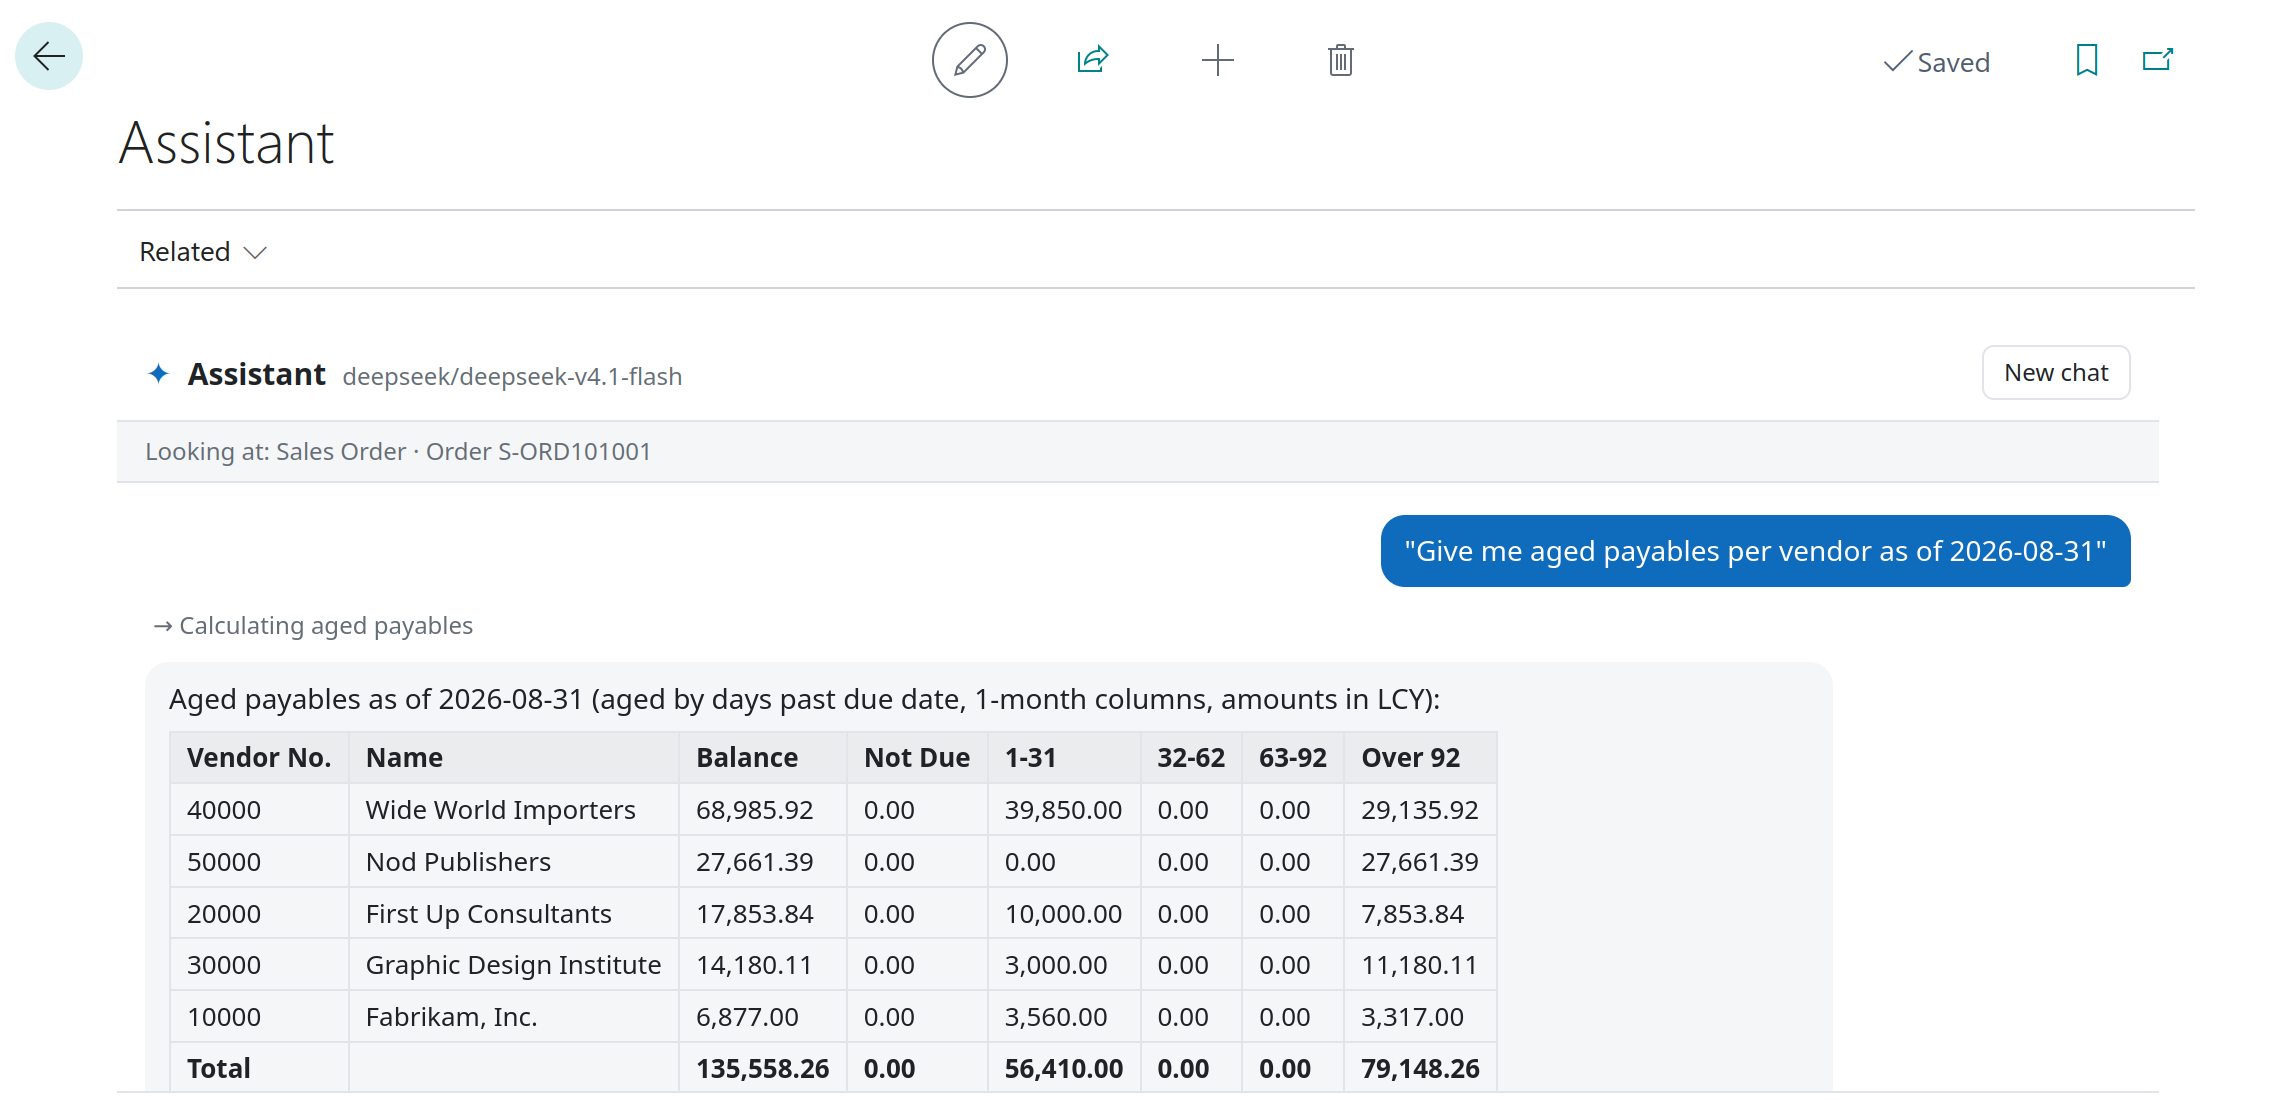
Une question de type rapport. La ligne au-dessus de la réponse montre quel outil a roulé.
L'architecture, en cinq morceaux
1. Un seul paramètre de point d'accès, n'importe quel modèle
L'extension parle le format chat-completions d'OpenAI et rien d'autre. Ollama, LM Studio, llama.cpp et vLLM l'offrent tous pour les modèles locaux, et OpenRouter l'offre pour les modèles hébergés. La page de configuration a donc besoin de trois choses : l'adresse du point d'accès, le nom du modèle et une clé d'API facultative.
Chaque appel HTTP est fait côté serveur, en AL. La clé d'API est gardée chiffrée dans l'isolated storage et ne se rend jamais au navigateur.
2. La page de clavardage : un contrôle intégré
Le clavardage lui-même est un contrôle intégré (control add-in) sur une page ordinaire : messages, tableaux Markdown, suggestions, et une ligne pour chaque recherche que fait l'assistant. Ce n'est que l'affichage. La conversation vit en AL.
3. La boucle d'outils, en AL
Le modèle ne voit pas la base de données. Il reçoit une liste d'outils qu'il peut demander, et l'AL les exécute :
get_screen_context: l'enregistrement d'où le clavardage a été ouvertsearch_tablesetget_table_fields: trouver une table et ses champsquery_recordsetcount_records: lire avec des filtresopen_page: ouvrir une fiche ou une liste
La boucle est courte. On envoie la conversation et la liste d'outils. Si le modèle demande des outils, on les exécute, on ajoute les résultats et on redemande. S'il répond en texte, on arrête. Une version simplifiée du vrai code :
for Round := 1 to Setup."Max Tool Rounds" + 1 do begin
    if Round > Setup."Max Tool Rounds" then
        FinalRound := true;                 // plus de recherches : répondre avec ce qu'on a
    if FinalRound then
        ToolDefinitions := NoTools;

    if not LLMClient.ChatCompletion(Setup, Messages, ToolDefinitions, AssistantMessage, ErrorText) then
        exit(false);

    if FinalRound or not HandleToolCalls(AssistantMessage, Activity) then begin
        Reply := LLMClient.GetContent(AssistantMessage);
        exit(true);
    end;
end;
Deux limites l'empêchent de s'emballer : un nombre maximal de tours d'outils (6 par défaut) et un temps maximal de réponse (90 secondes par défaut). Quand l'une est atteinte, on retire les outils et le modèle doit répondre avec ce qu'il a.
La sécurité vient de Business Central, pas de la consigne au modèle. Chaque lecture passe par un RecordRef et vérifie d'abord la permission de l'utilisateur lui-même :
RecRef.Open(TableId);
if not RecRef.ReadPermission() then
    Error('The user does not have permission to read table %1.', TableId);
L'assistant ne peut jamais montrer à un utilisateur quelque chose qu'il ne pourrait pas ouvrir lui-même.
4. Des jeux de données prêts : laisser Business Central faire le calcul
C'est le morceau qui a rendu les réponses fiables.
Un modèle de langage est bon pour comprendre une question et mettre un résultat en forme. Il n'est pas fiable pour additionner des centaines de lignes. Les questions de type rapport ne passent donc pas par les tables brutes. Elles passent par des jeux de données prêts : Business Central fait les jointures, les totaux et le classement par âge, idéalement dans un objet Query, et le modèle ne fait que filtrer, trier et présenter un petit résultat exact.
Un jeu de données est un codeunit qui implémente une interface :
interface "AI Dataset"
{
    procedure GetName(): Text;                 // nom de l'outil, p. ex. aged_receivables
    procedure GetDescription(): Text;          // le modèle lit ceci pour choisir l'outil
    procedure GetParameters(): JsonObject;     // schéma JSON des paramètres
    procedure DescribeCall(Args: JsonObject): Text;
    procedure Run(Args: JsonObject; MaxLength: Integer): Text;
}
Une énumération extensible sert de registre. Chaque valeur devient un outil :
enum 50150 "AI Dataset" implements "AI Dataset"
{
    Extensible = true;

    value(0; AgedReceivables)
    {
        Implementation = "AI Dataset" = "AI Aged Receivables Dataset";
    }
    // ...
}
Comme l'énumération est extensible, une extension propre à un client peut ajouter ses jeux de données sans toucher à celle-ci.
Quand aucun jeu de données ne convient à une question de type rapport, on dit au modèle de ne pas improviser à partir des tables brutes. Il appelle plutôt un outil report_missing_dataset et le dit à l'utilisateur.
5. Un journal des questions qui devient la liste de travail
Chaque question est enregistrée dans Business Central : le résultat, les outils utilisés, la durée, un pouce en haut ou en bas de l'utilisateur, et une chronologie de chaque étape, comme model 2.1s > aged_receivables 0.3s > model 4.0s. La chronologie dit si une réponse lente venait du modèle ou de Business Central.
Un filtre « à regarder » montre les jeux de données manquants, les erreurs et les réponses avec un pouce en bas. Cette liste, c'est la liste de ce qu'il faut construire ensuite. Ce qu'on garde est un paramètre (questions et réponses, questions seulement, ou rien), avec une durée de conservation, parce que les réponses peuvent contenir des données de clients.
Ce que j'ai appris avec un modèle local
- La fenêtre de contexte décide de tout. Ollama roule les modèles avec un contexte de 4 096 jetons par défaut et coupe sans rien dire le début de la conversation. Avec cette limite, Qwen tombait dans des boucles d'appels d'outils dans mes tests. Un Modelfile avec
num_ctx 16384a réglé ça. - Les vieux résultats d'outils doivent rapetisser. Avant chaque nouvelle question, les résultats des tours précédents sont coupés à un aperçu de 400 caractères, avec une note pour redemander au besoin. Sinon, un petit contexte se remplit vite.
- La vitesse et la précision tirent chacune de leur bord. Sur une carte graphique de 12 Go, un modèle Qwen 9B donnait les meilleures réponses. Gemma était environ deux fois plus rapide et moins précis.
- Certains modèles n'acceptent qu'un seul message système. Les notes en cours de conversation, comme « le temps est écoulé, réponds maintenant », sont envoyées comme messages de l'utilisateur pour cette raison.
- Business Central en ligne ne peut pas appeler
localhost. La requête part des serveurs de Microsoft, donc un modèle local doit être joignable en HTTPS par un tunnel. Un tunnel de test rapide rend votre modèle public, sans authentification, tant qu'il roule. Pour plus longtemps, mettez devant un proxy inverse qui vérifie un jeton. - Dans un sandbox, les appels HTTP sont fermés par défaut. Activez Allow HttpClient Requests pour l'extension, sinon chaque appel échoue.
Local ou hébergé : un vrai choix
La même extension fonctionne avec un modèle hébergé par OpenRouter. Je l'ai testée avec DeepSeek V4.1 Flash : pas de carte graphique, pas de tunnel, et très peu de frais par question.
Le compromis, c'est où vont les données. Avec un modèle hébergé, ce que les outils renvoient (noms, adresses, montants) sort de votre locataire et va chez le fournisseur. Avec un modèle local, ça reste sur votre machine. Aucun des deux n'est mauvais. Ça doit être une décision, prise avant de brancher l'assistant sur les vraies données de la compagnie.
Si vous construisez quelque chose du genre aujourd'hui
- Commencez en lecture seule. C'est là qu'est la valeur, et ça enlève toute une catégorie de risques.
- Utilisez les permissions de l'utilisateur. Faites chaque recherche en tant qu'utilisateur. Ne bâtissez pas un deuxième modèle de sécurité dans une consigne.
- Donnez moins de calcul au modèle. Chaque question de type rapport qui compte mérite son jeu de données.
- Dites au modèle ce qu'il ne doit pas faire. Le mien a la consigne de ne jamais décrire de menus ni de procédures étape par étape de mémoire, parce que ces réponses sont souvent fausses.
- Journalisez dès le premier jour. Les questions que les gens posent vraiment ne sont pas celles que vous aviez prévues.
Pas juste pour les données d'une compagnie
Rien ici n'est lié à une entreprise en particulier. Un distributeur pourrait ajouter un jeu de données pour les commandes en souffrance par fournisseur. Une entreprise de services, un pour l'utilisation des techniciens. Le clavardage, la boucle et la sécurité restent les mêmes.
Vous voulez un assistant dans Business Central qui répond à partir de vos propres données, sur le modèle de votre choix? Parlons-en.